Introdução à Análise de Algoritmos
Como medir e comparar o desempenho de algoritmos, do número de passos básicos à notação assintótica.
A melhor forma de resolver um problema depende de como os dados são armazenados e das operações feitas sobre eles: um algoritmo pode ser mais ou menos eficiente conforme a maneira como acessa os dados. Por isso, antes de estudar as estruturas de dados, precisamos de uma forma de medir e comparar algoritmos.
Depois de criar um algoritmo correto para um problema, um passo importante é determinar quanto de recursos (tempo e memória) ele consome. Um algoritmo que resolve o problema, mas demora um ano, dificilmente será usado; um que exige milhares de GB de memória não roda na maioria das máquinas.
Por que analisar algoritmos?
A análise de algoritmos nos permite prever o comportamento de um algoritmo sem que seja necessário implementá-lo.
Analisar um algoritmo significa:
- provar que ele está correto, ou seja, que funciona para qualquer entrada;
- estimar o tempo e a memória que a sua execução consome.
Como a memória raramente é o fator limitante, é comum analisar apenas o tempo de execução. E, para que a análise valha em qualquer situação, ela precisa ser independente do hardware e da linguagem de programação.
Como medir o tempo de execução?
Há três abordagens possíveis:
- Executar o programa e cronometrar. O resultado depende da máquina, do compilador, da carga do sistema e de vários outros fatores.
- Usar um computador padrão, com um conjunto de instruções de tempo conhecido. O algoritmo precisaria ser "traduzido" para essas instruções, e na maioria das vezes só nos interessam as operações mais significativas.
- Contar operações: definir uma função
que diz quantas vezes as operações relevantes são executadas para uma entrada de tamanho .
Usamos a terceira. A função
Tempo de execução: número de passos básicos executados, descrito em função do tamanho da entrada.
Para usar essa definição, precisamos dizer o que é um passo básico e o que é o tamanho de uma entrada.
Passo básico
São passos básicos as operações sobre números pequenos que um computador executa em tempo constante:
- operações aritméticas:
, , , , , , ; - operações relacionais:
, , , , , ; - operações lógicas:
, , ; - atribuição;
- acesso a uma posição de um vetor (leitura ou escrita);
- controle de fluxo:
if/else,for,while.
Tamanho da entrada
O tamanho da entrada é o tamanho da sua representação:
- vetores: número de elementos;
- inteiros: quantidade de bits;
- grafos: número de vértices e número de arestas.
Contando passos básicos
Exemplo 1: soma dos elementos
int soma(int *V, int n) {
    int soma = 0;
    for (int i = 0; i < n; i++)
        soma += V[i];
    return soma;
}
Quantos passos básicos são executados, em função de soma += V[i] vale um, dois ou três passos, damos a cada linha um custo
constante
| Linha | Custo | Vezes |
|---|---|---|
int soma = 0; | ||
int i = 0 | ||
i < n | ||
i++ | ||
soma += V[i]; | ||
return soma; |
O teste i < n é executado
para constantes
Exemplo 2: soma dos elementos pares
int somaPar(int *V, int n) {
    int soma = 0;
    for (int i = 0; i < n; i++)
        if (V[i] % 2 == 0)
            soma += V[i];
    return soma;
}O for sempre executa if nem sempre some.
Quantos passos? (tente antes de abrir)
O teste do if é executado soma += V[i] é executada
Exemplo 3: busca sequencial
int buscaSequencial(int *V, int n, int x) {
    for (int i = 0; i < n; i++)
        if (V[i] == x)
            return i;
    return -1;
}
Aqui o número de iterações depende de onde
Melhor caso, pior caso e caso médio
Quando o número de operações depende da entrada (e não só do seu tamanho),
calculamos
- melhor caso: o menor valor de
entre todas as entradas de tamanho ; - pior caso: o maior valor de
entre todas as entradas de tamanho ; - caso médio: a média de
sobre todas as entradas de tamanho .
Busca sequencial
Seja V[i] == x:
- melhor caso:
é o primeiro elemento, ; - pior caso:
é o último elemento ou não está no vetor, ; - caso médio: seja
a probabilidade de procurarmos o -ésimo elemento. Encontrá-lo custa comparações, então . Se todos têm a mesma probabilidade, , e
O programa abaixo conta as comparações em cada caso, num vetor com
Exemplo 4: maior elemento de um vetor
int maior(int A[], int n) {
    int max = A[0];
    for (int i = 1; i < n; i++)
        if (A[i] > max)
            max = A[i];
    return max;
}
Seja max, então
Esse algoritmo é ótimo em número de comparações: para garantir que um
elemento é o maior, é preciso que cada um dos outros
Mude os valores da entrada (em Dados de entrada) e veja que a contagem não muda:
Exemplo 5: maior e menor elementos
void MinMax1(int A[], int n, int *max, int *min) {
    *max = *min = A[0];
    for (int i = 1; i < n; i++) {
        if (A[i] > *max)
            *max = A[i];
        if (A[i] < *min)
            *min = A[i];
    }
}
Cada iteração faz duas comparações, então
Podemos melhorar com um else: um valor que acabou de virar o máximo não
precisa ser comparado com o mínimo.
void MinMax2(int A[], int n, int *max, int *min) {
    *max = *min = A[0];
    for (int i = 1; i < n; i++) {
        if (A[i] > *max)
            *max = A[i];
        else if (A[i] < *min)
            *min = A[i];
    }
}
Agora o número de comparações depende da entrada:
- melhor caso: vetor em ordem crescente. O teste
A[i] > *maxé sempre verdadeiro e o segundo nunca é feito:; - pior caso: o teste
A[i] > *maxé sempre falso (vetor em ordem decrescente, por exemplo), e o segundo teste é feito em toda iteração:; - caso médio: se
A[i] > *maxfor falso em metade das vezes, o segundo teste é feitovezes: .
O programa compara as duas versões em três vetores de 1000 elementos:
Dá para fazer melhor? Sim. Suponha A[0] com A[1], A[2] com A[3], e assim por diante. São
em qualquer entrada, menos que o caso médio da MinMax2. Guardar
vencedores e perdedores em dois vetores auxiliares exige memória extra; dá
para evitá-la processando cada par assim que ele é comparado.
Implemente a MinMax3, que compara os elementos aos pares. Use a função
maiorQue em toda comparação entre elementos, para que elas sejam contadas.
A meta é chegar a
E se os valores estiverem ordenados?
Voltando à busca: se o vetor estiver ordenado, a busca sequencial continua
fazendo
Busca binária
A busca binária é um método eficiente para encontrar um valor em um vetor ordenado. Em vez de procurar elemento por elemento, ela descarta metade do intervalo de busca a cada passo.
Como funciona:
- 1
Delimite o intervalo#
Comece com os dois extremos do vetor:
ini = 0efim = n - 1. - 2
Calcule o meio#
O índice do meio é
m = (ini + fim) / 2. - 3
Compare V[m] com x#
- se
V[m] == x, encontramos o elemento; - se
V[m] < x, o elemento só pode estar à direita:ini = m + 1; - se
V[m] > x, o elemento só pode estar à esquerda:fim = m - 1.
- se
- 4
Repita#
Volte ao passo 2 enquanto o intervalo não estiver vazio, isto é, enquanto
ini <= fim. Se ele ficar vazio,não está no vetor.
Por exemplo, procurando V = {1, 3, 5, 7, 9, 11, 13}:
| Iteração | ini | fim | m | V[m] | Decisão |
|---|---|---|---|---|---|
| 1 | 0 | 6 | 3 | 7 | fim = 2 |
| 2 | 0 | 2 | 1 | 3 | ini = 2 |
| 3 | 2 | 2 | 2 | 5 | fim = 1 |
| (fim) | 2 | 1 | ini > fim: devolve |
Agora é com você: complete a função buscaBinaria. O botão Executar roda
o seu código com a entrada que você digitar (no formato dos casos visíveis);
o botão Testar roda a bateria de casos, que inclui um vetor com um milhão
de elementos. Uma busca sequencial não termina esse caso dentro do limite de
tempo.
Ver uma solução
/* Considere que os valores no vetor V estão ordenados */
int buscaBinaria(int *V, int n, int x) {
    int ini = 0, fim = n - 1;
    while (ini <= fim) {
        int m = (ini + fim) / 2;
        if (V[m] == x)
            return m;
        else if (V[m] < x)
            ini = m + 1;
        else
            fim = m - 1;
    }
    return -1;
}
Quantas iterações faz a busca binária?
A cada iteração sem sucesso, o intervalo de busca cai pelo menos pela metade:
começa com
No pior caso, a busca sequencial faz
Com um milhão de elementos, são um milhão de iterações contra vinte.
Comparando algoritmos
Uma vez que o tempo de execução de um algoritmo é descrito como uma função do tamanho da entrada, podemos compará-lo com outros algoritmos que resolvem o mesmo problema.
O tempo de pior caso é o maior tempo de execução possível que o
algoritmo leva para resolver o problema considerando uma entrada de tamanho
O pior caso nos dá um limitante superior: nenhuma entrada de tamanho
Um algoritmo é eficiente se seu tempo de execução no pior caso é limitado superiormente por uma função polinomial no tamanho da entrada.
Taxas de crescimento
Suponha dois algoritmos para o mesmo problema, um com
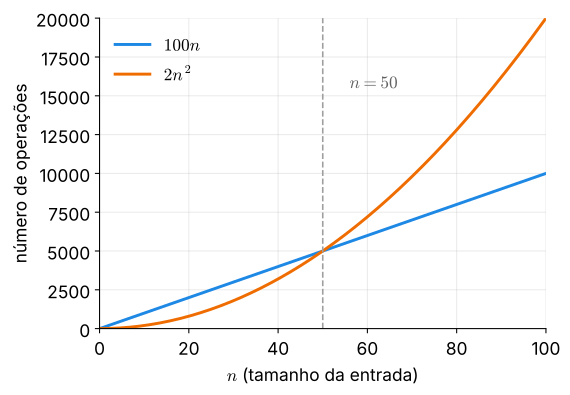

Para entradas pequenas, qualquer algoritmo, mesmo ineficiente, gasta pouco
tempo. O que importa na escolha é o comportamento para entradas grandes.
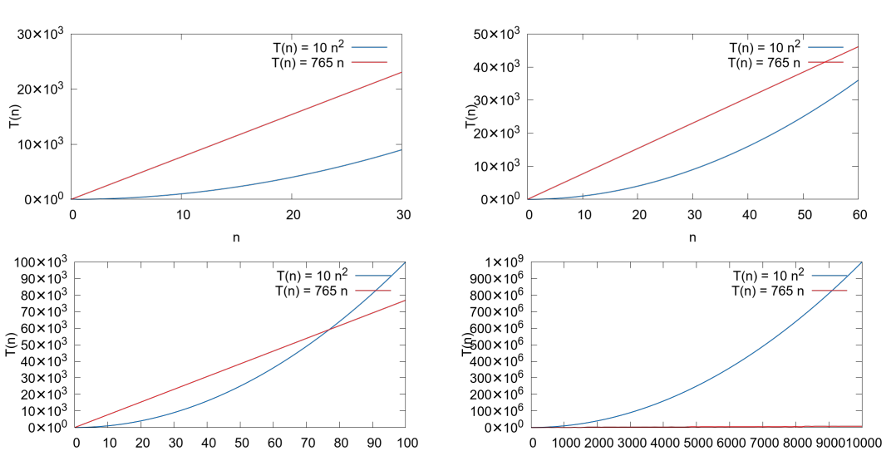
As figuras abaixo mostram as mesmas funções (
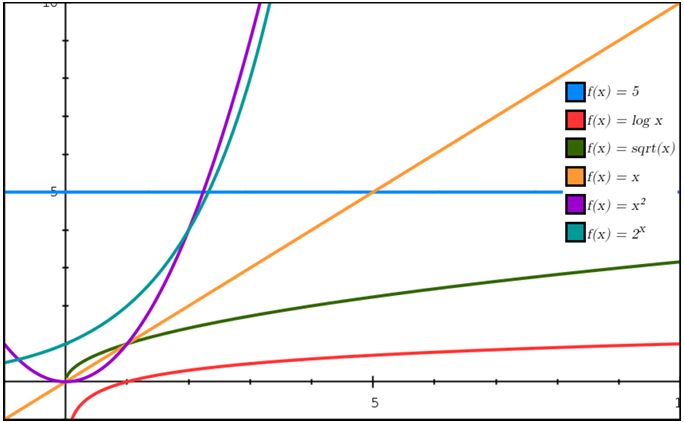
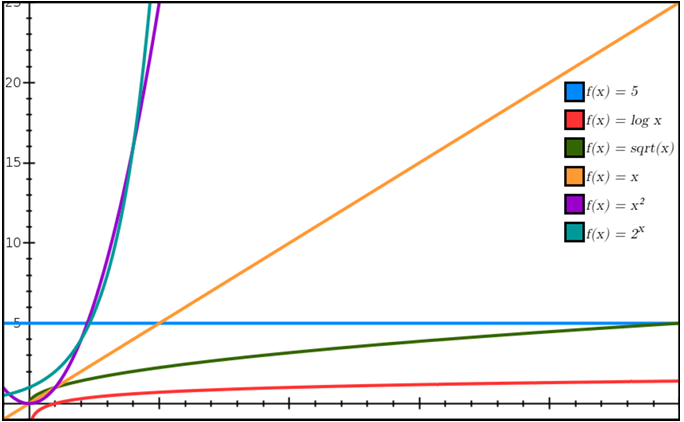
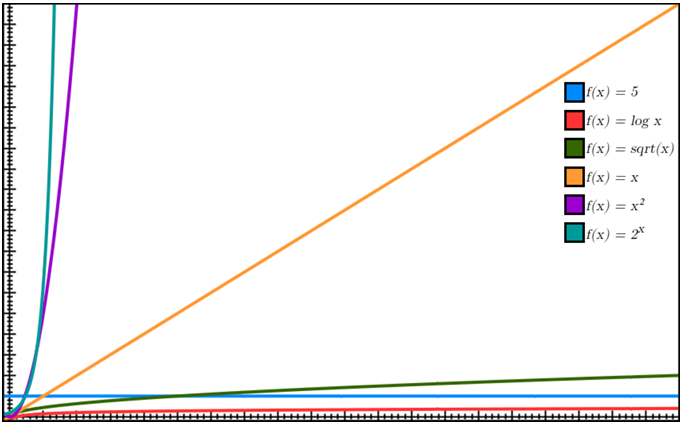
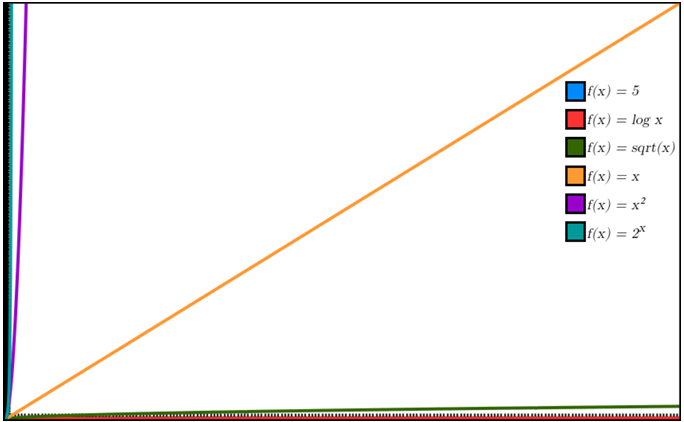
A tabela dá uma ideia dos números envolvidos:
| (inimaginável) |
Um computador que executa
Notação assintótica
Quando analisamos algoritmos, só nos interessam valores muito grandes de
Estamos interessados no que acontece com
- termos de menor ordem não importam;
- constantes multiplicativas não importam.
Assim,
A figura compara
Notação O (limite superior)
Sejam
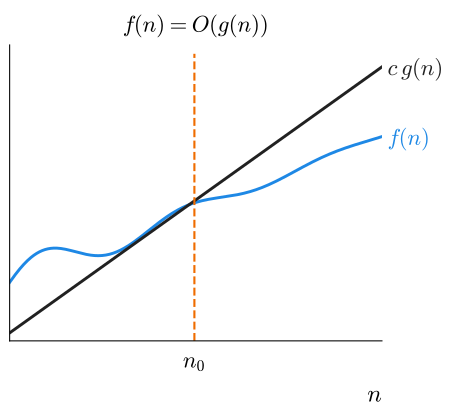

Ou seja, a partir de
Exemplo:
Exemplo:
Exemplos de funções
- Se
para uma constante positiva , então para qualquer ; - se
é um polinômio de grau , então ; - usamos
para indicar funções limitadas por uma constante.
Notação Ω (limite inferior)
Dizemos que
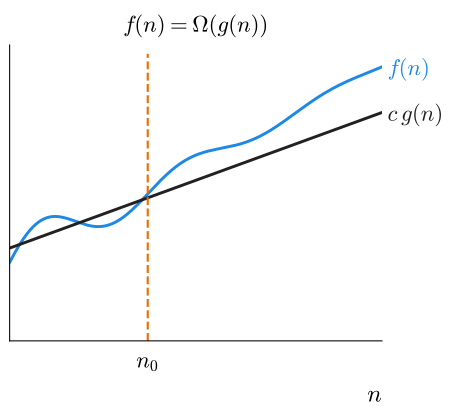

A notação
Exemplo:
Exemplo:
Notação Θ (limite exato)
Dizemos que
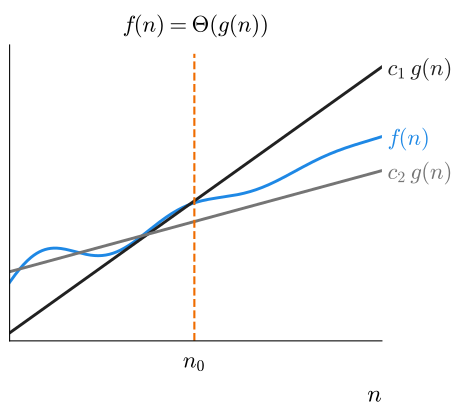

Exemplo:
Exemplo:
Principais classes de complexidade
| Classe | Nome | Quando aparece | Exemplo |
|---|---|---|---|
| constante | não depende do tamanho da entrada | acesso a uma posição de um vetor | |
| logarítmica | o problema é dividido ao meio sucessivamente | busca binária | |
| linear | uma operação para cada elemento da entrada | busca sequencial, maior elemento | |
| linearítmica | divide ao meio sucessivamente e depois junta os resultados | Mergesort, Heapsort | |
| quadrática | os elementos são processados aos pares, com laços aninhados | Selection Sort | |
| cúbica | três laços aninhados | multiplicação de matrizes | |
| exponencial | todas as combinações dos elementos | gerar todos os subconjuntos | |
| fatorial | todas as ordenações dos elementos | gerar todas as permutações |
Em ordem de crescimento:
Algoritmos exponenciais e fatoriais só são viáveis para entradas muito pequenas.
Técnicas de análise
Algumas regras práticas para obter a complexidade de um programa:
- Atribuição, leitura e escrita de tipos simples são
. - Numa sequência de comandos, vale o comando de maior complexidade.
- Num
if, somamos a complexidade do teste (geralmente) com a do bloco executado; no pior caso, o bloco mais caro. - Num laço, multiplicamos o número de iterações pela complexidade do corpo
(incluindo o teste de parada, geralmente
). - Com chamadas de funções, começamos pelas funções que não chamam nenhuma outra, depois pelas que só chamam funções já analisadas, e assim por diante.
- Funções recursivas são analisadas com equações de recorrência, que veremos mais adiante.
Por exemplo, na MinMax2 o corpo do laço é
Tempo e espaço
O algoritmo ideal gastaria pouco tempo e pouca memória, mas nem sempre isso
é possível: muitas vezes um algoritmo mais rápido usa mais memória, e
vice-versa (como na versão da MinMax3 com vetores auxiliares). Escolhemos
conforme a restrição mais importante. Em sistemas embarcados, com pouca
memória, preferimos o algoritmo mais econômico em espaço; em sistemas de tempo
real, o mais rápido, mesmo que use mais memória.
Resumo
- A análise de algoritmos permite prever desempenho e correção sem implementar.
- Tempo de execução é o número de passos básicos em função do tamanho da entrada.
- Quando o custo depende da entrada, distinguimos melhor caso, pior caso e caso médio; o pior caso dá um limitante superior.
- A notação
descreve o crescimento assintótico, ignorando constantes e termos de menor ordem; dá um limite inferior e , um limite exato. - Em vetores ordenados, a busca binária (
) é assintoticamente melhor que a busca sequencial ( ).
Exercícios
1. Quantas vezes a linha x++ é executada em cada trecho, em função de
/* (a) */
for (int i = 0; i < n; i++)
    for (int j = 0; j < n; j++)
        x++;

/* (b) */
for (int i = 0; i < n; i++)
    for (int j = i + 1; j < n; j++)
        x++;

/* (c) */
for (int i = 1; i < n; i = i * 2)
    x++;
Resposta
- (a)
vezes: . - (b) para cada
, o laço interno roda vezes: vezes, que também é . - (c)
assume os valores enquanto : são vezes (para ), ou seja, .
2. Mostre que
Resposta
Queremos
3. Verdadeiro ou falso? Justifique.
- (a)
- (b)
- (c)
- (d)
Resposta
- (a) Verdadeiro:
, então e servem. - (b) Falso:
, e exigiria para todo grande, o que nenhuma constante satisfaz. - (c) Verdadeiro:
para . - (d) Falso:
exigiria para todo grande.
4. Ordene as funções pela taxa de crescimento, da menor para a maior:
Resposta
5. Termine o desafio da MinMax3:
compare os elementos aos pares e chegue a
Referências
- C. N. Lintzmayer e G. O. Mota. Análise de Algoritmos e de Estruturas de Dados. UFABC.
- C. N. Lintzmayer. Notas de aula. UFABC.
- T. H. Cormen, C. E. Leiserson, R. L. Rivest e C. Stein. Introduction to Algorithms. 3. ed. MIT Press.
- R. Sedgewick e K. Wayne. Algorithms. 4. ed. Addison-Wesley, 2011.
- P. Feofiloff. Análise de algoritmos. IME-USP.