Estruturas genéricas
Uma única implementação para qualquer tipo de dado com void * e callbacks, com a lista e a árvore de busca genéricas, o cuidado com o dono de cada dado e uma lista com tipos diferentes em cada nó.
Até aqui, cada estrutura de dados que implementamos guardava um tipo fixo: a
lista guardava int, a árvore de busca guardava pares de int. Se o
programa precisar de uma lista de strings, ou de uma árvore de alunos, a
saída mais direta é copiar a implementação inteira e trocar o tipo. Nesta
página, vamos juntar duas ferramentas já vistas, o
ponteiro void * e as
funções de callback, para escrever uma única
implementação de cada estrutura, que sirva para qualquer tipo de dado.
O problema: uma estrutura para cada tipo
Uma lista duplamente encadeada de inteiros tem um nó assim:
typedef struct noInt {
    int dado;
    struct noInt *anterior;
    struct noInt *proximo;
} NoInt;

void insereFimListaInt(ListaInt *lista, int dado);
void imprimeListaInt(const ListaInt *lista);   /* printf("%d", ...) */
Para uma lista de double, como NoInt guarda um int, não há o que
reaproveitar: é preciso copiar NoInt, ListaInt e todas as funções,
trocando int por double em cada uma. Para strings, mais uma cópia,
agora alocando memória para o texto. Para um struct Aluno, mais uma.
Com fim em uma remoção,
por exemplo) precisa ser corrigido em todas as cópias. E o mesmo vale para
pilhas, filas, árvores, tabelas de símbolos...
Entre as versões para int, double, string e Aluno, o que muda de uma
implementação para outra? E o que fica exatamente igual?
Ver respostaEsconder resposta
Fica igual toda a lógica de encadeamento: criar e ligar nós, atualizar
inicio, fim e tamanho, percorrer a lista. Mudam só as operações que
precisam conhecer o tipo do dado: guardá-lo no nó, comparar dois dados
(na busca), imprimir um dado e liberar um dado (a string e o nome do
aluno precisam de free, o int não). É exatamente essa separação que
as estruturas genéricas exploram.
A ideia: void * e callbacks
A estrutura não precisa saber o que guarda. O nó passa a guardar um
void *, um ponteiro para um dado de qualquer tipo, que fica fora do
nó. E as operações que dependem do tipo (comparar, imprimir, liberar)
chegam como callbacks, escritos por quem usa a estrutura e sabe o que há
por trás do ponteiro.
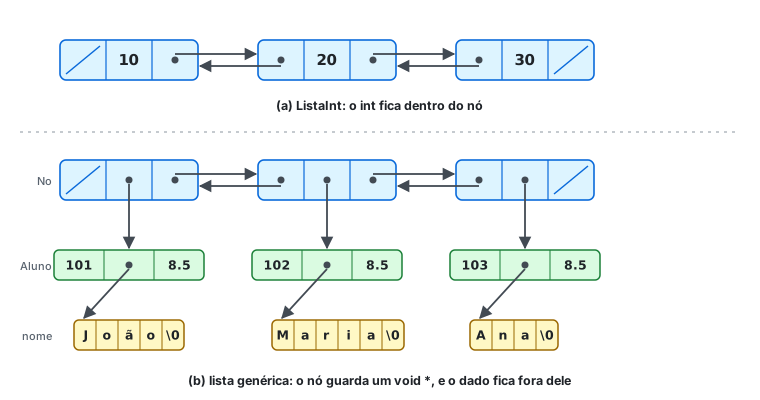
Uma estrutura de dados genérica é uma implementação que pode guardar
elementos de qualquer tipo. Em C, ela guarda ponteiros genéricos
(void *) para os dados e recebe por callbacks as operações que dependem
do tipo, como comparar, imprimir e liberar.
A biblioteca padrão já usa essa ideia: o qsort ordena vetores de qualquer
tipo porque recebe o tamanho de cada elemento e um comparador. A diferença é
que, aqui, a ideia vai para dentro de uma estrutura de dados inteira.
A lista genérica
O TAD abaixo é a lista duplamente encadeada das páginas anteriores, com
void *dado no lugar de int dado. Os tipos dos callbacks ficam no .h,
com typedef:
typedef int (*Comparador)(const void *a, const void *b);
typedef void (*Impressor)(const void *dado);
typedef void (*Liberador)(void *dado);
Quase todo o código é igual ao da lista de inteiros. As diferenças aparecem
em poucos lugares. A busca recebe a chave como const void * e um
comparador, e devolve o dado encontrado (e não o nó, que é interno ao
TAD):
void *buscaLista(const Lista *lista, const void *chave, Comparador comparar) {
    if (lista == NULL || chave == NULL || comparar == NULL)
        return NULL;
    for (No *p = lista->inicio; p != NULL; p = p->proximo)
        if (comparar(p->dado, chave) == 0)
            return p->dado;
    return NULL;
}
A impressão chama um Impressor para cada dado. E a liberação recebe um
Liberador, porque nem sempre um free(dado) basta (um aluno tem o nome
alocado à parte):
void liberaLista(Lista *lista, Liberador liberar) {
    if (lista == NULL)
        return;
    No *atual = lista->inicio;
    while (atual != NULL) {
        No *proximo = atual->proximo;
        if (liberar != NULL)
            liberar(atual->dado);       /* só quem conhece o tipo sabe liberar */
        free(atual);
        atual = proximo;
    }
    free(lista);
}
Com liberar igual a NULL, só os nós são liberados, e os dados ficam com
quem os criou. Veremos mais adiante quando isso é
necessário.
As remoções (removeInicioLista, removeFimLista, removePosicaoLista)
devolvem o void * que estava no nó removido e não liberam o dado:
quem chamou pode querer usá-lo antes de decidir o que fazer com ele.
O programa abaixo usa a mesma implementação para uma lista de inteiros e
uma lista de strings. Explore os arquivos Lista.h e Lista.c: nenhuma
linha deles menciona int ou char como tipo dos dados.
Para cada tipo, o main escreve só os callbacks: comparar e imprimir. Para
liberar, free serve tanto para o int quanto para a string, porque cada
dado é um único bloco alocado com malloc. O próprio free pode ser
passado como Liberador: a assinatura void free(void *) é exatamente a
que o tipo pede.
buscaLista(numeros, &chave, compararInt) passa um ponteiro para um int
com o valor procurado, porque o comparador espera dois ponteiros para
int. Na lista de strings, a chave é a própria string. A chave precisa ter
o tipo que o comparador espera (veja o Programa 2 dos
exercícios para o que acontece quando não tem).
As funções do TAD começam testando lista == NULL. Em
lista == NULL || lista->inicio == NULL, a ordem importa: como || para
assim que o resultado está decidido, lista->inicio só é avaliado quando
lista não é NULL. São duas perguntas diferentes: a primeira protege
contra um ponteiro inválido, e a segunda pergunta se a lista está vazia.
Uma lista de structs
O caso mais comum na prática é guardar structs. O Aluno tem o nome
alocado dinamicamente, com o tamanho certo. Os callbacks do aluno ficam em
um módulo próprio, Aluno.h e Aluno.c, que vamos reaproveitar na árvore
genérica.
Dois detalhes:
- A chave da busca é um
Alunoem que só a matrícula foi preenchida ({.matricula = 102}), porquecompararMatriculasó olha esse campo. liberarAlunolibera primeiro o nome e depois o struct. PassarfreeparaliberaListaliberaria só o struct, e os nomes vazariam.
Quem é o dono do dado?
Numa estrutura genérica, a estrutura guarda ponteiros, e não cópias. Isso levanta uma pergunta que a lista de inteiros nunca teve: quem é responsável por liberar cada dado? A regra que seguimos é a de um único dono:
- Ao inserir, o dado (alocado por quem chamou) passa a ser da estrutura.
- Ao remover, a estrutura devolve o dado, que volta a ser de quem chamou. Ele precisa ser liberado (ou inserido em outro lugar).
- Ao destruir a estrutura, o liberador recebido libera os dados que ainda estavam nela.
for (int i = 0; i < 5; i++) {
    int x = 10 * i;
    insereFimLista(lista, &x);      /* ERRADO */
}
Todos os nós guardam o mesmo endereço, o de x, que deixa de existir
ao fim de cada volta do laço (e, se a lista for usada fora da função, ao
fim da função). Além disso, um liberaLista(lista, free) tentaria liberar
uma variável que não foi alocada com malloc. Cada dado inserido precisa
da sua própria área, alocada com malloc.
Map, filter e para cada
As funções de alta ordem da página anterior
também funcionam sobre a lista genérica. mapLista e filterLista devolvem
uma lista nova. paraCadaLista chama um callback para cada dado, com um
contexto, e faz o papel do reduce: o contexto acumula o resultado, sem
nenhuma alocação.
Lista *mapLista(const Lista *lista, Transformadora transformar);
Lista *filterLista(const Lista *lista, Predicado condicao);
void paraCadaLista(const Lista *lista, Visita visita, void *contexto);
Há uma diferença importante entre map e filter. O map cria dados
novos (o callback transformar aloca cada um). Já o filter coloca na
lista nova os mesmos ponteiros da lista original.
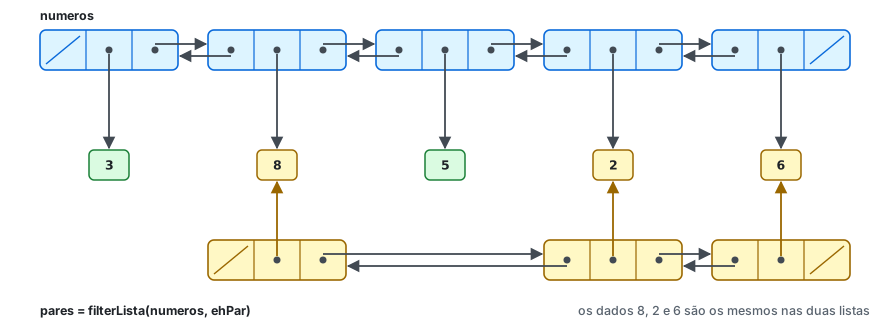
O contexto de paraCadaLista funciona como na página anterior. Em somar,
ele é um long long * com a soma. Em guardarMaior, é o endereço de um
ponteiro (int **) que, no fim, aponta para o maior dado, sem copiá-lo.
No fim do main, cada lista é liberada de um jeito, de acordo com quem é
dono dos dados: numeros libera os seus, pares libera só os nós (os dados
são de numeros) e dobrados libera os dados que o map criou.
Uma lista turma guarda alunos criados com criaAluno, e
aprovados = filterLista(turma, aprovado). Como liberar tudo corretamente?
Callback da operação ou da estrutura?
Na lista, cada operação recebe o callback de que precisa: buscaLista
recebe um comparador, imprimeLista recebe um impressor. Isso é flexível:
a mesma lista de alunos pode ser buscada por matrícula em um momento e por
nome em outro, porque a busca na lista olha todos os elementos, um a um.
Em uma árvore de busca, isso não funciona. A posição de cada dado na árvore
depende do comparador usado na inserção. Se cada insere ou busca
pudesse receber um comparador diferente, a busca seguiria o caminho errado
e não encontraria dados que estão na árvore. O comparador faz parte da
definição da árvore: ele é escolhido na criação, guardado na estrutura
e usado em todas as operações.
| Callback | Onde fica | Por quê |
|---|---|---|
| comparador da busca na lista | parâmetro da operação | a busca é sequencial, qualquer critério funciona |
| comparador da árvore de busca | guardado na estrutura | a ordem da árvore depende dele |
| liberador da árvore | guardado na estrutura | usado ao destruir a árvore (e ao remover) |
| visita do percurso | parâmetro da operação | cada percurso faz uma coisa diferente |
A árvore de busca genérica
A árvore genérica é a árvore binária de busca
com void *dado nos nós e com o comparador e o liberador guardados na
estrutura:
struct arvore {
    No *raiz;
    int tamanho;
    Comparador comparar;        /* os callbacks ficam guardados na árvore */
    Liberador liberar;
};

Arvore *criaArvore(Comparador comparar, Liberador liberar);
A busca é a mesma da árvore de inteiros. A única mudança é que as
comparações < e > viram uma chamada ao comparador, e o sinal do
resultado decide o caminho:
void *buscaArvore(const Arvore *arvore, const void *chave) {
    No *p = arvore->raiz;
    while (p != NULL) {
        int c = arvore->comparar(chave, p->dado);
        if (c == 0)
            return p->dado;
        p = c < 0 ? p->esq : p->dir;
    }
    return NULL;
}
O programa abaixo cria duas árvores com os mesmos alunos: uma em ordem
de nome e outra em ordem de matrícula. Os módulos Aluno.h e Aluno.c são
os mesmos da lista, sem nenhuma mudança.
Alguns pontos para observar:
- Duas árvores, um dono.
porNomeé criada comliberarAlunoe é a dona dos alunos.porMatriculaé criada comNULL: ela funciona como um índice, que só aponta para os alunos. É assim que bancos de dados mantêm vários índices sobre os mesmos registros. - Inserção recusada.
insereArvoredevolvefalsequando já existe um dado equivalente (paracompararNome, um aluno com o mesmo nome). Nesse caso, a árvore não guarda o dado, e ele continua sendo de quem chamou, que precisa liberá-lo. - Percurso com contexto.
percorreArvorevisita os alunos em ordem, e o contexto acumula a soma das notas para a média. É o mesmo padrão do exercício de percurso com callback.
Por que insereArvore devolve false em vez de, como na árvore de
inteiros, simplesmente substituir o dado antigo pelo novo?
Ver respostaEsconder resposta
Por causa do dono. Na árvore de inteiros, substituir um valor não
envolve memória. Aqui, se a árvore trocasse o dado antigo pelo novo,
precisaria decidir o que fazer com o antigo: liberá-lo (mas ele pode
estar em uso por quem chamou, ou em outra estrutura, como na árvore
porMatricula) ou devolvê-lo (o que complicaria a interface). Devolver
false e deixar o novo dado com quem chamou mantém a regra simples:
cada dado tem um único dono, e a árvore só libera o que aceitou.
Uma lista com tipos diferentes em cada nó
Em Python, uma lista pode misturar tipos: [42, "olá", 3.14] é válida.
Nas estruturas acima, cada uma guarda vários dados, mas todos do mesmo
tipo: quem chama imprimeLista sabe se deve passar imprimirInt ou
imprimirAluno. Dá para misturar tipos na mesma lista?
Um void * sozinho não basta. Ele não carrega nenhuma informação sobre o
tipo do dado: essa informação se perde quando o ponteiro original é
convertido para void *. Olhando só para o ponteiro, um callback não tem
como saber se deve convertê-lo para int *, double * ou char *.
A solução é guardar o tipo junto com o dado. Em vez do dado, a lista
recebe um pequeno pacote, o Elemento, com uma etiqueta (tag) que
diz o tipo e um ponteiro para o valor:
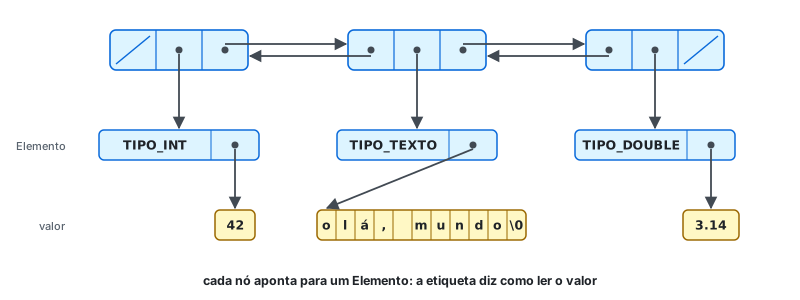
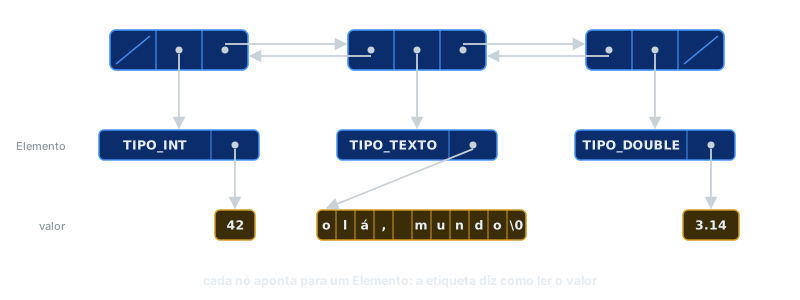
A lista não mudou nada. Os callbacks consultam a etiqueta (com um switch)
antes de converter o ponteiro. Essa é uma versão simplificada do que o
Python faz por dentro: todo objeto Python carrega uma referência para o seu
tipo, e é assim que o interpretador sabe, durante a execução, o que cada
elemento é.
O que acontece se um Elemento tiver a etiqueta TIPO_DOUBLE, mas o seu
valor for, na verdade, um int? O compilador consegue detectar esse erro?
Ver respostaEsconder resposta
O compilador não detecta: para ele, valor é só um void *, e a
etiqueta é um número qualquer. Durante a execução, imprimirElemento
converte o ponteiro para double * e lê 8 bytes onde há um int de 4:
o resultado é um número sem sentido (e o AddressSanitizer ainda acusa a
leitura fora da área alocada). Em Python, um erro de tipo gera uma
exceção controlada. Em C, nada além do cuidado de quem escreve o código
garante que a etiqueta corresponde ao valor.
O Elemento acima faz uma alocação extra por valor. Uma variação comum
guarda o valor dentro do próprio struct, com uma union (que reserva
espaço para o maior dos tipos e usa o mesmo espaço para qualquer um
deles). A combinação de uma etiqueta com uma union é chamada de união
com etiqueta (tagged union).
Vantagens e desvantagens
Vantagens:
- Uma única implementação para todos os tipos: um erro corrigido na lista genérica fica corrigido para todos os usos.
- Um tipo novo exige só os seus callbacks (comparar, imprimir, liberar), e não uma reimplementação.
- A mesma ideia vale para qualquer estrutura: listas, pilhas, filas, árvores, tabelas de símbolos, filas de prioridade.
Desvantagens:
- Menos verificação de tipos. O compilador não confere se um
void *aponta para o tipo que o callback espera. Um erro vira acesso inválido à memória ou resultado errado durante a execução. - Gerenciamento de memória mais delicado. É preciso definir quem é o dono de cada dado, e o liberador certo precisa chegar a cada estrutura.
- Custo extra. Cada dado é uma alocação à parte, e cada comparação é uma chamada de função por ponteiro. Para um único tipo, com desempenho crítico, uma estrutura escrita para aquele tipo é mais rápida.
Outras linguagens resolvem o mesmo problema com recursos próprios, como os
templates de C++ e os generics de Java e C#, em que o compilador gera
ou verifica o código para cada tipo e mantém a verificação de tipos. Em C,
void * com callbacks é a forma padrão.
Exercícios
Encontre e corrija o erro
Os programas abaixo usam a lista genérica desta página. Cada um tem um erro diferente. Execute, leia a mensagem e encontre a causa.
Programa 1
Resposta
As listas são impressas corretamente, mas o programa termina com
attempting double-free dentro de liberaLista. A lista pares foi criada
por filterLista, que guarda os mesmos ponteiros da lista numeros.
Depois de liberaLista(numeros, free), os dados pares já foram liberados, e
liberaLista(pares, free) tenta liberá-los de novo. A lista pares não é
dona dos dados e deve liberar só os nós:
liberaLista(numeros, free);
liberaLista(pares, NULL);
Programa 2
Resposta
O programa termina com global-buffer-overflow em compararNome, chamada
por buscaLista. A chave da busca é a string "Ana", mas compararNome
espera dois ponteiros para Aluno: ela converte a string para Aluno * e
lê o campo nome, que está 8 bytes depois do início do struct, além do
fim dos 4 bytes de "Ana". O compilador não reclama, porque qualquer
ponteiro vira void * sem aviso. A chave precisa ser um Aluno, com o
campo que o comparador usa:
Aluno chave = {.nome = (char *)procurados[i]};
Aluno *achou = buscaLista(turma, &chave, compararNome);
Programa 3
Resposta
O programa termina com heap-use-after-free em liberarAluno, na primeira
vez que ela é chamada (no aluno removido da posição 2). A função libera o
struct antes do nome: depois de free(aluno), ler aluno->nome é
acessar memória já liberada. O que está dentro do struct precisa ser
liberado primeiro:
void liberarAluno(void *dado) {
    Aluno *aluno = dado;
    free(aluno->nome);
    free(aluno);
}
Programa 4
Este programa acrescenta à lista a função removeSeLista, que remove
todos os dados que satisfazem um predicado. O erro está nela, no arquivo
Lista.c.
Resposta
A lista final está correta, mas o programa termina com vazamentos de
memória: 38 bytes em 3 blocos, todos alocados em criaAluno, na linha do
malloc do nome. São os nomes dos três alunos removidos. Os quatro casos
de remoção estão certos, mas o dado é liberado com free(atual->dado), que
libera só o struct. O parâmetro liberar, que sabe liberar um Aluno
inteiro, nunca é usado. Com uma lista de inteiros, o erro não apareceria, e
é por isso que removeSeLista precisa receber o liberador:
if (liberar != NULL)
    liberar(atual->dado);
free(atual);
Implemente
Inserção ordenada e remoção com predicado. Acrescente à lista genérica duas funções:
insereOrdenadoLista(lista, dado, comparar), que insere o dado mantendo a lista em ordem crescente segundocomparar. Se houver dados equivalentes ao novo, ele entra depois deles.removeSeLista(lista, condicao, liberar), que remove todos os dados que satisfazemcondicao, libera cada um comliberar(se ele não forNULL) e devolve quantos foram removidos.
As duas funções ficam em extras.c, que tem acesso à estrutura interna da
lista (ListaInterno.h). Os testes conferem os encadeamentos (anterior,
proximo, inicio, fim) e o tamanho depois de cada operação, quais
dados foram liberados, e removem elementos de uma lista com 200 mil
elementos.
Em removeSeLista, quais casos de remoção existem? E como percorrer a
lista sem perder o próximo nó?
Ver dica 1Esconder dica 1
Guarde atual->proximo antes de liberar o nó atual. Depois da remoção,
continue a partir dele.
Ver dica 2Esconder dica 2
Em vez de quatro casos (único, primeiro, último, meio), trate os dois
lados separadamente: se o nó tem anterior, o anterior passa a apontar
para o próximo, senão inicio muda. Se o nó tem próximo, o próximo
passa a apontar para o anterior, senão fim muda. Não use
removePosicaoLista dentro do laço: cada chamada percorre a lista desde
o início, e a remoção ficaria quadrática.
Ver dica 3Esconder dica 3
Em insereOrdenadoLista, avance enquanto comparar(p->dado, dado) <= 0.
Com < 0, o novo entraria antes dos equivalentes.
Remoção na árvore de busca genérica. Implemente
removeArvore(arvore, chave), que remove da árvore genérica o dado
equivalente à chave e o libera com o liberador da árvore (se ele não for
NULL), devolvendo false se não havia dado equivalente. O restante do TAD
é o desta página. Os testes conferem a ordem da árvore e o tamanho, qual
dado foi liberado em cada remoção, e fazem até 200 mil remoções.
Na remoção de um nó com dois filhos, o dado do sucessor vem para o nó removido. Qual dado precisa ser liberado, e quando?
Ver dica 1Esconder dica 1
A estrutura da remoção é a da árvore de busca,
com arvore->comparar(chave, r->dado) no lugar de < e >.
Ver dica 2Esconder dica 2
O dado liberado é o que sai da árvore, o do nó encontrado. Libere-o
antes de sobrescrever r->dado com o dado do sucessor. O nó do
sucessor sai da árvore, mas o dado dele continua nela: libere só o nó.
Contador de palavras. Usando apenas a interface da árvore genérica
(Arvore.h), implemente o contador de palavras de palavras.h. Cada
Palavra guarda o texto (uma cópia alocada) e quantas vezes ele apareceu.
contaPalavra acrescenta uma ocorrência, imprimeContagem imprime as
palavras em ordem alfabética com as suas contagens e maisFrequente
devolve a palavra que mais apareceu (no empate, a primeira em ordem
alfabética). Os testes contam 400 mil palavras e conferem que toda a
memória é liberada no fim.
Que comparador e que liberador criaContador deve passar para a árvore?
E como buscar uma palavra a partir de um const char *?
Ver dica 1Esconder dica 1
O comparador compara os campos texto com strcmp. O liberador libera
o texto e depois o struct. Os dois podem ser funções static em
palavras.c.
Ver dica 2Esconder dica 2
Para buscar, monte uma Palavra só com o texto (como a chave da busca
por nome desta página). Se a palavra não existir, crie uma com uma
cópia do texto (malloc e strcpy): quem chamou reaproveita o seu
texto depois da chamada.
Ver dica 3Esconder dica 3
imprimeContagem e maisFrequente são percursos com
percorreArvore. Em maisFrequente, o contexto pode ser o endereço de
um const Palavra * com a melhor até agora. Como o percurso é em ordem
alfabética, troque a melhor só quando a contagem for estritamente maior.
Referências
- A. Backes. Linguagem C: Completa e Descomplicada. 2ª ed. Elsevier, 2018.
- D. R. Hanson. C Interfaces and Implementations: Techniques for Creating Reusable Software. Addison-Wesley, 1996.
- B. W. Kernighan e R. Pike. A Prática da Programação. Campus, 2000. Capítulo 2.