Tipo Abstrato de Dados
Interface, implementação e cliente. Como esconder os campos de uma struct, separar um programa em módulos e compilar cada parte separadamente.
Um tipo de dado define um conjunto de valores e as operações que podem ser
feitas com eles: um int guarda inteiros em uma certa faixa e pode ser
somado, comparado, impresso. A linguagem C também oferece formas de
estruturar dados a partir dos tipos básicos, como vetores, struct e
enum.
Muitas vezes isso não basta. Um programa que lida com alunos, frações ou datas precisa de um tipo novo e de um conjunto de operações para manipulá-lo, e precisa que os valores desse tipo nunca fiquem em um estado inválido (um CR negativo, uma data 31 de abril, uma fração com denominador zero).
Um tipo abstrato de dados é um tipo definido pelo programador, junto com as operações que podem ser feitas sobre ele. Ele é descrito pela sua finalidade e pelas suas operações, não pela forma como é implementado. Abstrato quer dizer exatamente isso: abstraída a forma de implementação.
Quem usa um TAD só precisa conhecer as operações disponíveis, como faz
com os tipos da própria linguagem: você soma dois double sem saber como os
bits estão organizados. Quem implementa o TAD escolhe as estruturas e
escreve as operações. Para quem usa, o TAD é uma caixa-preta.
Por que um TAD?
Considere um programa que guarda nome, matrícula e CR de um aluno. O CR deve ficar sempre entre 0 e 10, então as funções que mexem nele limitam o valor a esse intervalo:
As funções fazem o trabalho certo: alteraCR(a, 12.0) deixa o CR em 10. Mas
nada impede o código que usa a struct de escrever direto nos campos, como
a->cr = -999, e deixar o aluno em um estado que as funções nunca
produziriam. Em um programa grande, com várias pessoas mexendo, esse tipo de
atalho aparece, e o erro só é percebido muito longe de onde aconteceu.
Por que criaAluno usa strncpy em vez de strcpy? E por que a linha seguinte escreve '\0' em nome[MAX - 1]?
strcpy copia até encontrar o '\0' da origem, sem saber o tamanho do
destino: um nome com mais de 49 caracteres escreveria além do vetor nome
(estouro de buffer). strncpy(a->nome, nome, MAX - 1) copia no máximo
MAX - 1 caracteres. Só que, quando a origem é maior que isso, strncpy
não coloca o '\0' no fim. Por isso a linha seguinte o coloca
explicitamente na última posição.
A solução é que só as funções do TAD possam mexer nos campos. Em C, isso é feito separando o programa em arquivos.
Interface, implementação e cliente
Um TAD em C costuma ser dividido em dois arquivos, e o programa que o usa fica em um terceiro:
- Interface (
Aluno.h): declara o tipo e os protótipos das operações. É tudo o que o usuário do TAD vê. - Implementação (
Aluno.c): define astructcom os campos e o código das operações. Fica escondida do usuário. - Cliente (
main.c): o programa que usa o TAD. Inclui só a interface.
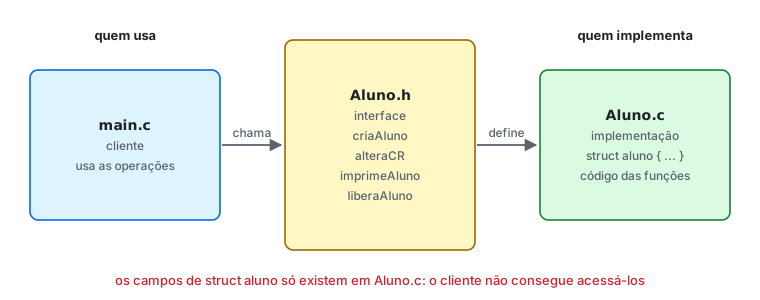
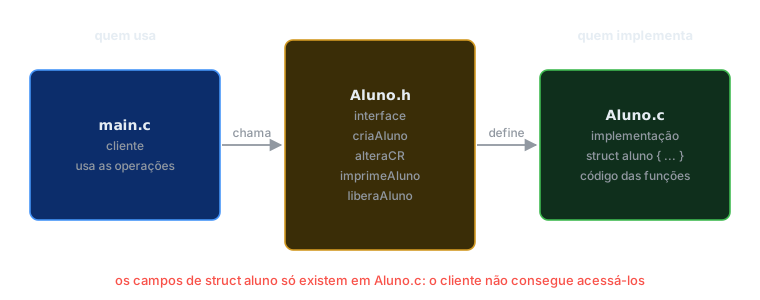
Essa divisão em módulos (unidades com um propósito bem definido, que podem ser compiladas separadamente) tem várias vantagens:
- Encapsulamento: o usuário não precisa saber como o TAD funciona por dentro, só quais operações existem.
- Integridade: como os campos só são alterados pelas operações, o TAD nunca fica em um estado inválido.
- Manutenção: dá para mudar a implementação (trocar um vetor por outra estrutura, acrescentar um campo) sem mudar uma linha do cliente.
- Reutilização: o mesmo TAD pode ser usado em vários programas, sem copiar e colar código.
- Compilação separada: ao alterar um módulo, só ele precisa ser recompilado (veja Compilação e Make).
As operações variam de TAD para TAD, mas quase sempre existem operações para criar e destruir (liberar) o TAD, e para inserir, remover e consultar os dados guardados nele.
O TAD Aluno em módulos
Clique nas abas para ver cada arquivo. Execute e, depois, tire o comentário
da linha a->cr = -999; em main.c e execute de novo.
Agora o acesso direto não compila:
main.c:11:6: error: invalid use of incomplete typedef 'Aluno' {aka 'struct aluno'}
   11 |     a->cr = -999;
      |      ^~
O que garante isso é a linha typedef struct aluno Aluno; em Aluno.h. Ela
diz que existe uma struct aluno, mas não diz quais campos ela tem: para
quem inclui só o .h, Aluno é um tipo incompleto (ou opaco). O
cliente pode declarar ponteiros Aluno * e passá-los para as funções, mas não
pode acessar campos, nem declarar uma variável Aluno (sem ponteiro), nem
usar sizeof(Aluno). Os campos só são conhecidos dentro de Aluno.c, onde a
struct aluno é definida. A ocultação deixa de ser uma convenção ("por favor,
não mexa nos campos") e passa a ser garantida pelo compilador.
Repare em mais três detalhes da implementação:
Aluno.cincluiAluno.h. Primeiro, porque precisa do tipoAluno. Segundo, porque assim o compilador confere se cada função implementada tem o mesmo tipo do protótipo da interface.limitaCRéstatic. Uma funçãostaticsó é visível dentro do próprio arquivo. Ela é um detalhe da implementação e não aparece na interface: o cliente não pode chamá-la.#define MAX 50também ficou emAluno.c. O tamanho do vetornomeé um detalhe da implementação.
Por que as funções levam o nome do TAD (criaAluno, liberaAluno) em vez de apenas cria e libera?
Em C não existe sobrecarga de funções: duas funções não podem ter o mesmo
nome no mesmo programa, mesmo que estejam em arquivos diferentes e recebam
parâmetros diferentes. Um programa que usa o TAD Ponto e o TAD Círculo
precisa de liberaPonto e liberaCirculo; se os dois se chamassem libera,
a ligação falharia com multiple definition. O nome do TAD no fim (ou no
começo) de cada função evita esses conflitos e deixa claro, no cliente, a qual
TAD a operação pertence.
TAD Ponto
Um ponto no plano, com as operações:
criaPonto: cria um ponto com coordenadas; liberaPonto: libera a memória do ponto;acessaPonto: devolve as coordenadas do ponto (por meio de ponteiros);atribuiPonto: atribui novas coordenadas ao ponto;distanciaPonto: calcula a distância entre dois pontos.
Note que acessaPonto precisa devolver dois valores. Como uma função só tem
um valor de retorno, ela recebe os endereços de duas variáveis do cliente e
escreve nelas, como scanf faz.
Lendo só Ponto.h, não dá para saber se o ponto guarda as coordenadas em
dois campos double, em um vetor de duas posições ou em coordenadas polares.
A implementação poderia trocar uma representação por outra, e main.c
continuaria funcionando sem nenhuma alteração.
Diretivas do pré-processador
Antes de compilar, o gcc passa cada arquivo .c pelo pré-processador, que
trata as linhas que começam com #. Um #include "Ponto.h", por exemplo, é
substituído pelo conteúdo inteiro de Ponto.h.
Include guard
Um mesmo cabeçalho pode acabar incluído mais de uma vez no mesmo arquivo,
quase sempre de forma indireta. No TAD Círculo (próxima seção), Circulo.h
inclui Ponto.h, porque uma das operações recebe um Ponto. Um cliente que
usa os dois TADs inclui Ponto.h e Circulo.h, e o conteúdo de Ponto.h
aparece duas vezes. Repetir protótipos não é problema, mas definições como a
de uma struct não podem aparecer duas vezes, e o compilador acusa
redefinition.
Para evitar isso, todo .h é cercado por um include guard:
#ifndef PONTO_H
#define PONTO_H

/* conteúdo da interface */

#endif
Na primeira vez que o arquivo é processado, o símbolo PONTO_H não está
definido: o #ifndef (if not defined) é verdadeiro, o símbolo é definido e
o conteúdo é considerado. Da segunda vez em diante, PONTO_H já existe, e
tudo até o #endif é ignorado. O nome do símbolo pode ser qualquer um; o
costume é usar o nome do arquivo em maiúsculas.
Compilação condicional
As mesmas diretivas servem para ligar e desligar trechos de código.
#if 0 ... #else ... #endif desativa o primeiro trecho (troque por #if 1
para inverter). #ifdef DEBUG ... #endif só mantém o trecho se o símbolo
DEBUG estiver definido, o que é útil para mensagens de depuração:
Comente a linha #define DEBUG e execute de novo: as mensagens somem, sem
apagar nenhum printf. Com a linha comentada, também dá para ligar as
mensagens na hora de compilar, sem mexer no código: gcc -DDEBUG debug.c
define o símbolo DEBUG para aquele arquivo.
TAD Círculo
Um círculo é dado pelo centro e pelo raio, com as operações criaCirculo,
liberaCirculo, areaCirculo e interiorCirculo (verifica se um ponto está
dentro do círculo). Ele usa o TAD Ponto: o centro é um Ponto *, e
interiorCirculo recebe um Ponto. Mesmo assim, Circulo.c não conhece os
campos do ponto: ela usa criaPonto, distanciaPonto e liberaPonto, como
qualquer outro cliente.
main.c inclui Ponto.h e Circulo.h, que inclui Ponto.h de novo; os
include guards fazem a segunda inclusão ser ignorada. Repare também em
liberaCirculo: ela libera o centro antes de liberar o círculo. Na
ordem inversa, c->centro seria lido depois do free(c).
Suponha que você acrescente uma função imprimePonto ao TAD Ponto e passe a usá-la em main.c. O que precisa ser feito para gerar o executável de novo?
Declarar o protótipo em Ponto.h e implementar a função em Ponto.c. Como
Ponto.c e main.c mudaram, os dois precisam ser recompilados. Circulo.c
não mudou, mas inclui Ponto.h (por meio de Circulo.h), que mudou; por
segurança, ele também deve ser recompilado. Por fim, os arquivos objeto são
ligados de novo. Fazer isso à mão é fácil de errar; o make faz por você
(veja Compilação e Make).
Compilando um programa com vários arquivos
Aqui na página, os botões compilam tudo para você. No terminal, a primeira tentativa costuma ser compilar só o cliente:
gcc main.c -lm -o TADPonto/usr/bin/ld: /tmp/ccGosmEZ.o: in function `main':
main.c:(.text+0x34): undefined reference to `criaPonto'
main.c:(.text+0x4d): undefined reference to `criaPonto'
main.c:(.text+0x64): undefined reference to `distanciaPonto'
...
collect2: error: ld returned 1 exit status(Em um sistema em português, a mensagem é referência não definida para
"criaPonto".) O erro não é do compilador, é do ligador (ld). main.c
compilou sem problemas: o #include "Ponto.h" trouxe os protótipos, e isso
basta para compilar as chamadas. Mas o código das funções está em Ponto.c,
que não foi compilado, e o ligador não tem de onde tirar criaPonto.
Um programa com vários módulos é construído em duas etapas:
- Compilação: cada
.cé compilado separadamente, gerando um arquivo objeto (.o) com o código de máquina das funções daquele arquivo. A opção-cdiz ao gcc para parar aqui, sem gerar executável. - Ligação: o ligador junta os arquivos objeto, e o código das
bibliotecas usadas (como a matemática, com
-lm), em um único executável. É só nessa etapa que se confere se cada função chamada existe em algum lugar.
gcc -c Ponto.c                       # gera Ponto.o
gcc -c main.c                        # gera main.o
gcc main.o Ponto.o -lm -o TADPonto   # liga os dois e gera o executável
./TADPonto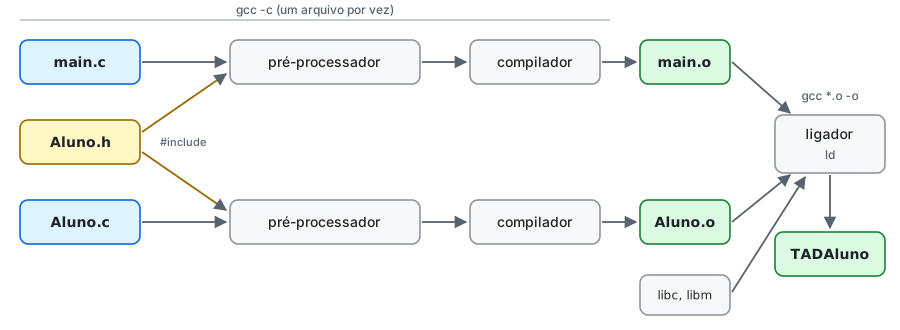
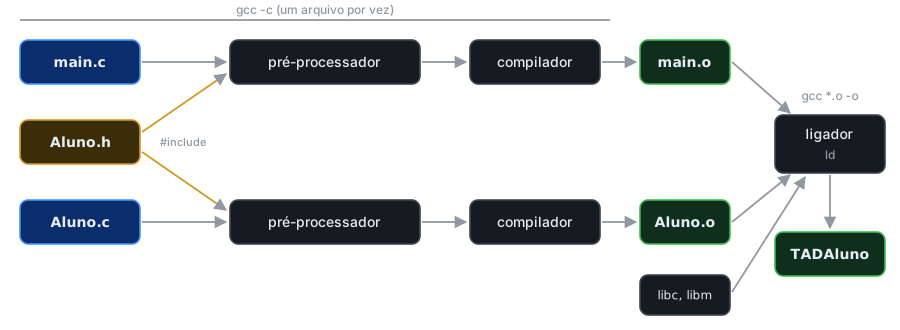
Também dá para fazer tudo de uma vez, com gcc main.c Ponto.c -lm -o TADPonto: o gcc compila os dois arquivos e liga o resultado, sem guardar os
.o.
Se os dois jeitos geram o mesmo executável, qual a vantagem de compilar separadamente?
Recompilar só o que mudou. Se apenas Ponto.c foi alterado, basta gerar
Ponto.o de novo e refazer a ligação; main.o continua valendo. Em um
projeto com dezenas de arquivos, compilar tudo a cada alteração é lento.
O difícil é lembrar exatamente o que precisa ser recompilado, e é isso que o
make automatiza: veja Compilação e Make.
Exercícios
Encontre e corrija o erro
Cada projeto tem um erro. Execute, leia as mensagens (de compilação, de ligação ou de execução), corrija e execute de novo.
Projeto 1
Resposta
A função separador está definida (com corpo) em Contador.h. Como
main.c e Contador.c incluem o cabeçalho, cada arquivo objeto ganha a sua
cópia da função, e o ligador acusa multiple definition of 'separador'. O
include guard não ajuda: ele evita a repetição dentro de um mesmo .c,
não entre arquivos diferentes. No .h fica só o protótipo
(void separador(void);); o corpo vai para Contador.c.
Projeto 2
Resposta
Os cabeçalhos não têm include guard. main.c inclui Ponto.h e depois
Circulo.h, que inclui Ponto.h de novo, e a struct ponto é definida duas
vezes: redefinition of 'struct ponto'. A correção é cercar Ponto.h com
#ifndef PONTO_H / #define PONTO_H / #endif (e fazer o mesmo em
Circulo.h, por hábito).
Projeto 3
A saída deveria ser Distancia: 2.9155 e q = (4.5, 6.5), distancia: 5.0000.
Resposta
Ponto.c não inclui Ponto.h e implementa criaPonto(float x, float y),
enquanto a interface promete criaPonto(double x, double y). Como cada .c é
compilado separadamente, o compilador nunca vê os dois juntos: main.c passa
dois double, criaPonto lê dois float, e os pontos são criados com
coordenadas erradas. Nem o ligador percebe, porque em C ele só compara
nomes, não tipos. Incluindo Ponto.h em Ponto.c, a divergência vira erro de
compilação (conflicting types for 'criaPonto') e a correção fica óbvia.
Projeto 4
Resposta
Em liberaCirculo, o círculo é liberado antes do centro: depois de
free(c), a leitura de c->centro acessa memória já liberada
(heap-use-after-free). Versões recentes do gcc (a partir da 12) também
avisam já na compilação: pointer 'c' used after 'free'. A ordem certa é liberar primeiro o que está dentro da struct
e depois a struct:
void liberaCirculo(Circulo *c) {
    liberaPonto(c->centro);
    free(c);
}
Implemente
Nos dois exercícios, a interface (.h) já está pronta e não pode ser
alterada. Os campos da struct ficam no .c, e toda operação precisa
deixar o TAD em um estado válido.
TAD Fração. Uma fração é guardada sempre na forma canônica:
simplificada, com o denominador positivo e com o zero representado como
0/1. Por exemplo, criaFracao(4, -6) representa criaFracao(10, 4) representa
TAD Data. Uma data do calendário entre 01/01/0001 e 31/12/9999. A criação recusa datas que não existem (31/04, 29/02 de um ano não bissexto, mês 13), e as operações avançam dias e contam os dias entre duas datas.
Referências
- W. Celes, R. Cerqueira e J. L. Rangel. Introdução a Estruturas de Dados: com técnicas de programação em C. 2ª ed. Grupo GEN, 2016.
- A. Backes. Estrutura de Dados Descomplicada em Linguagem C. Elsevier, 2016.
- F. Varejão. Introdução à Programação. Grupo GEN, 2014.
Busca sequencial e binária
Os dois algoritmos básicos de busca em vetores, com sentinela, versões recursivas, primeira e última ocorrência, busca binária na resposta e os erros mais comuns.
Compilação separada e Make
As etapas da compilação, a compilação de projetos com vários arquivos e como automatizá-la com Makefile.