Tabela de símbolos
O TAD que associa valores a chaves únicas. Interface, implementações com lista encadeada e com vetor ordenado (busca binária) e a comparação de custos que motiva as árvores.
Muitos programas precisam guardar informações para encontrá-las depois a partir de um identificador:
- o sistema acadêmico encontra o registro de um aluno (nome, curso, notas) a partir da matrícula;
- o DNS encontra o endereço IP de um site a partir do nome do site;
- um dicionário encontra a definição a partir da palavra;
- um compilador encontra o tipo e o endereço de uma variável a partir do identificador que aparece no código. É daqui que vem o nome "tabela de símbolos".
Em todos esses casos há pares (chave, valor): a chave identifica, e o valor é a informação associada a ela. A chave tem que ser única: não pode haver dois alunos com a mesma matrícula. A chave funciona como um "endereço" do valor, e a única forma de chegar ao valor é por meio dela.
Uma tabela de símbolos (TS) é uma estrutura que guarda pares chave-valor, com chaves únicas, e oferece basicamente duas operações: inserir um par (put) e buscar o valor associado a uma chave (get).
Outros nomes comuns para a mesma ideia são dicionário, mapa e
array associativo. Em Python é o dict; em C++, o std::map; em Java, o
Map. Em C, não há uma pronta: vamos construí-la.
Interface do TAD
/* TS.h */
#ifndef TS_H
#define TS_H

#include <stdbool.h>

typedef int Chave;
typedef int Valor;
typedef struct ts TS;

TS *criaTS(void);
void liberaTS(TS *ts);

/* Se a chave já existe, troca o valor; senão, insere o par */
void insereTS(TS *ts, Chave chave, Valor valor);

/* Ponteiro para o valor associado à chave, ou NULL se ela não existe.
   O ponteiro vale até a próxima inserção ou remoção. */
Valor *buscaTS(const TS *ts, Chave chave);

/* Remove o par com essa chave (se não existe, nada acontece) */
void removeTS(TS *ts, Chave chave);

int tamanhoTS(const TS *ts);
bool vaziaTS(const TS *ts);
void imprimeTS(const TS *ts);

#endif
Algumas decisões dessa interface:
ChaveeValorsãotypedefs. Aqui os dois sãoint, mas o resto do código só usa os nomesChaveeValor. Para guardar, por exemplo, notas (double) indexadas por matrícula, bastaria trocar otypedefdo valor. Trocar a chave por uma string exige mais cuidado, como mostra o primeiro exercício desta página.insereTStambém atualiza. Como as chaves são únicas, inserir uma chave que já existe não cria um segundo par: substitui o valor antigo.buscaTSdevolve um ponteiro. ComNULLpara "não encontrada", não é preciso reservar um valor especial (como o-1da pilha), que poderia ser um valor legítimo.
Além de resolver a ambiguidade do "não encontrada", que outra vantagem tem
buscaTS devolver um ponteiro para o valor, e não uma cópia dele?
Ver respostaEsconder resposta
O ponteiro permite alterar o valor diretamente na tabela, sem uma segunda busca. Contar ocorrências fica assim:
Valor *v = buscaTS(ts, x);
if (v != NULL)
    (*v)++;                 /* já existe: incrementa no lugar */
else
insereTS(ts, x, 1); /* primeira ocorrência */O ponteiro devolvido por buscaTS aponta para dentro da estrutura. Uma
inserção ou remoção posterior pode mudar os pares de lugar ou liberar a
memória, e o ponteiro passa a apontar para o lugar errado ou para memória
liberada. Use o ponteiro logo, e busque de novo depois de alterar a tabela.
O Programa 4 dos exercícios mostra o que acontece quando
isso é esquecido.
A sequência abaixo mostra o efeito das operações em uma tabela inicialmente vazia. Os pares estão listados sem nenhuma ordem particular.
| Operação | Devolve | Tabela depois da operação |
|---|---|---|
ts = criaTS() | ||
vaziaTS(ts) | true | |
insereTS(ts, 5, 100) | ||
insereTS(ts, 7, 200) | ||
insereTS(ts, 2, 300) | ||
insereTS(ts, 2, 500) | ||
buscaTS(ts, 7) | ponteiro para o 200 | |
buscaTS(ts, 4) | NULL | |
removeTS(ts, 5) | ||
tamanhoTS(ts) | 2 |
Implementação com lista encadeada
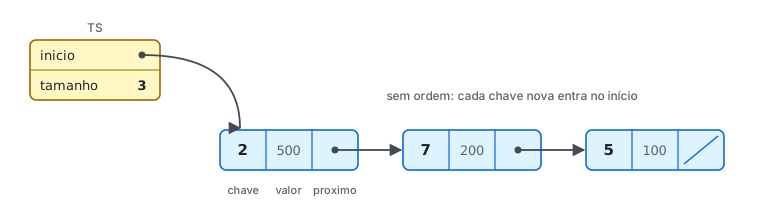
Uma forma simples é usar uma lista simplesmente encadeada em que cada nó guarda um par.
typedef struct no {
    Chave chave;
    Valor valor;
    struct no *proximo;
} No;

struct ts {
    No *inicio;
    int tamanho;
};
Todas as operações começam pela mesma busca sequencial: percorrer a lista até achar a chave ou chegar ao fim.
/* Busca sequencial: devolve o nó com a chave, ou NULL */
static No *procura(const TS *ts, Chave chave) {
    for (No *p = ts->inicio; p != NULL; p = p->proximo)
        if (p->chave == chave)
            return p;
    return NULL;
}

void insereTS(TS *ts, Chave chave, Valor valor) {
    No *p = procura(ts, chave);
    if (p != NULL) {                /* chave já existe: atualiza */
        p->valor = valor;
        return;
    }
    No *novo = malloc(sizeof(No));  /* chave nova: entra no início */
    novo->chave = chave;
    novo->valor = valor;
    novo->proximo = ts->inicio;
    ts->inicio = novo;
    ts->tamanho++;
}

Valor *buscaTS(const TS *ts, Chave chave) {
    No *p = procura(ts, chave);
    return p == NULL ? NULL : &p->valor;
}
Repare que até a inserção precisa da busca: antes de criar um nó, é preciso saber se a chave já existe. A remoção é a mesma da lista encadeada, guardando o nó anterior durante a busca.
A chave nova entra no início da lista. Haveria alguma vantagem em inserir no fim?
Ver respostaEsconder resposta
Não em custo: a inserção já percorre a lista inteira para verificar se a
chave existe, então ela é
Seria melhor usar uma lista duplamente encadeada?
Ver respostaEsconder resposta
Para a tabela de símbolos, não. A vantagem da lista dupla é remover um
nó em
A tabela também pode guardar os pares em um vetor, sem nenhuma ordem.
Os custos são os mesmos da lista: buscar é realloc)
quando enche. A remoção tem um truque: como a ordem dos pares não importa,
o último par ocupa o lugar do removido, e nada precisa ser deslocado.
  void removeTS(TS *ts, Chave chave) {
      int i = procura(ts, chave);                 /* posição da chave, ou -1 */
      if (i == -1)
          return;
      ts->pares[i] = ts->pares[ts->tamanho - 1];  /* o último ocupa o buraco */
      ts->tamanho--;
  }
É a ordem que encarece o vetor: no vetor ordenado, a seguir, a busca fica muito mais rápida, mas inserir e remover passam a deslocar pares.
Implementação com vetor ordenado
A lista é lenta porque a busca é sequencial. Com os pares em um vetor
ordenado pela chave, a busca pode ser binária: compara-se a chave
procurada com a do meio do vetor e descarta-se a metade em que ela não pode
estar. A cada passo o intervalo cai pela metade, e a busca custa
typedef struct {
    Chave chave;
    Valor valor;
} Par;

struct ts {
    Par *pares;         /* ordenados pela chave */
    int tamanho;
    int capacidade;
};
A busca binária abaixo devolve a posição da chave: se ela existe, é onde ela está; se não existe, é onde ela deveria entrar para manter o vetor ordenado (o número de chaves menores que ela).
static int posicao(const TS *ts, Chave chave) {
    int ini = 0, fim = ts->tamanho - 1;
    while (ini <= fim) {
        int meio = ini + (fim - ini) / 2;
        if (ts->pares[meio].chave < chave)
            ini = meio + 1;
        else if (ts->pares[meio].chave > chave)
            fim = meio - 1;
        else
            return meio;
    }
    return ini;
}
Com ela, a busca é imediata. A inserção de uma chave nova, porém, precisa abrir espaço na posição certa: todos os pares depois dela andam uma casa para a direita.
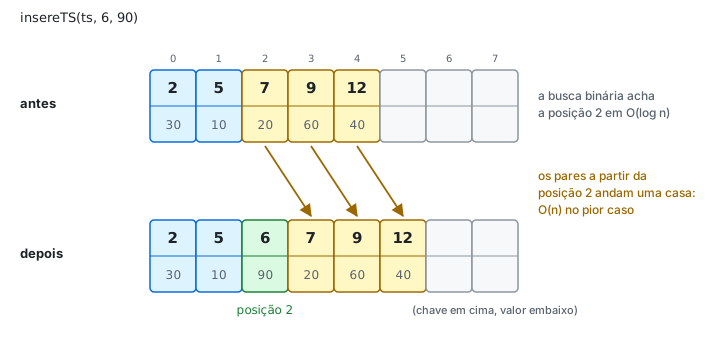
void insereTS(TS *ts, Chave chave, Valor valor) {
    int i = posicao(ts, chave);
    if (i < ts->tamanho && ts->pares[i].chave == chave) {
        ts->pares[i].valor = valor;         /* chave já existe: atualiza */
        return;
    }
    if (ts->tamanho == ts->capacidade) {    /* vetor cheio: dobra */
        ts->capacidade *= 2;
        ts->pares = realloc(ts->pares, ts->capacidade * sizeof(Par));
    }
    for (int j = ts->tamanho; j > i; j--)   /* abre espaço na posição i */
        ts->pares[j] = ts->pares[j - 1];
    ts->pares[i].chave = chave;
    ts->pares[i].valor = valor;
    ts->tamanho++;
}
Quando o vetor enche, a capacidade dobra (com realloc), e por isso a
tabela não tem limite de tamanho, como a versão com lista. Dobrar custa
copiar o vetor, mas isso acontece tão raramente que, distribuído entre todas
as inserções, sai por
O main.c e o TS.h abaixo são os mesmos da versão com lista. A única
diferença na saída é a ordem em que imprimeTS mostra os pares: agora,
sempre por chave.
Quanto a busca binária ganha da sequencial? O programa abaixo conta quantas chaves cada uma examina, em média, em vetores de tamanhos crescentes (metade das chaves buscadas não existe).
Cada vez que
Comparando as implementações
| Implementação | Buscar | Inserir | Remover | Listar em ordem de chave |
|---|---|---|---|---|
| Vetor não ordenado | ||||
| Lista encadeada | ||||
| Vetor ordenado |
Os custos são de pior caso, para uma tabela com
- o vetor não ordenado e a lista inserem e removem sem deslocar nada, mas não têm como evitar a busca sequencial: para achar uma chave, só percorrendo. Os custos das duas são idênticos, porque o que importa aqui não é vetor ou lista, e sim a falta de ordem;
- o vetor ordenado busca rápido, mas paga caro para manter a ordem a cada inserção ou remoção.
O ideal seria juntar o melhor dos dois: a busca binária do vetor e a inserção sem deslocamentos da estrutura encadeada. É exatamente isso que fazem as árvores binárias de busca, assunto das próximas páginas. Elas implementam esta mesma interface, e cada uma vai acrescentar uma linha a esta tabela.
Uma tabela de símbolos com vetor ordenado começa vazia, e são inseridas as
chaves
Exercícios
Encontre e corrija o erro
Programa 1
Resposta
insereTS não verifica se a chave já existe: insere sempre um nó novo. A
chave 7 fica duas vezes na lista, e o tamanho fica 2. A busca parece
funcionar, porque encontra o nó mais recente (que está no início), mas a
remoção tira só esse nó, e o par antigo, (7, 1), "reaparece". A inserção
precisa começar pela busca:
for (No *p = ts->inicio; p != NULL; p = p->proximo)
    if (p->chave == chave) {
        p->valor = valor;
        return;
    }
Programa 2
Resposta
O laço que abre espaço anda da esquerda para a direita: pares[i + 1]
recebe pares[i] antes de seu conteúdo ser copiado para a frente, e o
mesmo par é copiado em cascata até o fim. O par (40, 4) é sobrescrito e se
perde, e o (30, 3) aparece duas vezes. O deslocamento para a direita tem
que começar pelo fim:
for (int j = ts->tamanho; j > i; j--)
    ts->pares[j] = ts->pares[j - 1];
Programa 3
Resposta
A condição do laço é ini < fim, então a busca para quando o intervalo
ainda tem um elemento (ini == fim), sem examiná-lo. É o que acontece
com as chaves 20 e 50: a busca vai estreitando o intervalo até sobrar só a
posição delas, e desiste. A condição correta é ini <= fim: a busca só
termina quando o intervalo fica vazio.
Programa 4
Resposta
O ponteiro contador foi obtido antes das inserções e usado depois delas.
Na quinta inserção, o vetor enche e realloc o move para outro lugar da
memória, liberando o antigo: contador passa a apontar para memória
liberada (heap-use-after-free). Mesmo sem realloc, inserir uma chave
menor que 1 deslocaria os pares, e contador passaria a apontar para o
valor de outra chave. A correção é buscar de novo a cada uso:
for (int k = 2; k <= 8; k++) {
    insereTS(ts, k, 0);
    (*buscaTS(ts, 1))++;
}
Implemente
Frequência de palavras. Adapte a TS com lista encadeada para chaves do
tipo string: em TS.h, a chave já é const char *, e o TS.c inicial é
o desta página, sem mais nenhuma alteração. Ele compila, mas não funciona.
Os testes contam as palavras de um texto, e todas as palavras são lidas no
mesmo vetor de caracteres.
Por que trocar só o typedef da chave não basta?
Ver dica 1Esconder dica 1
O que p->chave == chave compara quando as chaves são ponteiros?
Ver dica 2Esconder dica 2
Se a tabela guarda o ponteiro recebido, e quem chamou reaproveita o mesmo
vetor para ler a próxima palavra, o que acontece com as chaves já
guardadas? (Para copiar uma string, use malloc e strcpy; a strdup
não faz parte do C11.)
Lista auto-organizável. Em muitas aplicações, poucas chaves concentram
a maior parte das buscas. Implemente a busca da TS com lista de modo que,
ao encontrar uma chave, o nó dela seja movido para o início da lista
(move-to-front). Assim, as chaves mais buscadas tendem a ficar perto do
início. Como a busca agora altera a lista, ela deixa de receber um ponteiro
const. Os testes fazem um milhão de buscas concentradas em oito chaves que
foram inseridas primeiro (e por isso estão no fim da lista).
Operações ordenadas. O vetor ordenado responde rápido a perguntas que
dependem da ordem das chaves, e que a lista só responderia percorrendo
tudo. Implemente, em
minTSemaxTS: a menor e a maior chave;rankTS: quantas chaves são menores que uma chave dada;pisoTSetetoTS: a maior chave menor ou igual, e a menor chave maior ou igual, a uma chave dada (que não precisa estar na tabela).
Por exemplo, com as chaves 10, 20, 30 e 50, o rank de 25 é 2, o piso de 25 é 20, e o teto é 30.
Referências
- R. Sedgewick e K. Wayne. Algorithms. 4ª ed. Addison-Wesley, 2011. Capítulo 3 (Searching).
- W. Celes, R. Cerqueira e J. L. Rangel. Introdução a Estruturas de Dados: com técnicas de programação em C. 2ª ed. Grupo GEN, 2016.
- A. Backes. Estrutura de Dados Descomplicada em Linguagem C. Elsevier, 2016.
Filas
Estrutura FIFO, que insere no fim e remove do início. Implementações com vetor (da ingênua à circular) e com lista encadeada, e o problema de Josefo.
Conceitos
Árvores como estrutura hierárquica. Definição recursiva, terminologia, propriedades com demonstração e formas de representar uma árvore qualquer.