Filas
Estrutura FIFO, que insere no fim e remove do início. Implementações com vetor (da ingênua à circular) e com lista encadeada, e o problema de Josefo.
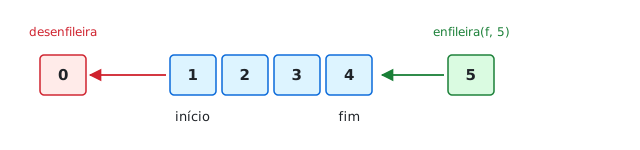
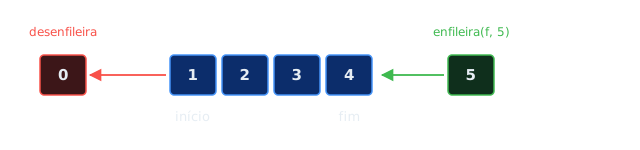
Na pilha, o último elemento a entrar é o primeiro a sair. Uma fila (queue) faz o contrário: os elementos saem na ordem de chegada, como em uma fila de banco, em que quem chega primeiro é atendido primeiro. Essa política é chamada de FIFO (First In, First Out).
Em uma fila, só se insere no fim e só se remove do início. Os elementos do meio ficam inacessíveis, mesmo estando guardados na memória. Alguns usos na computação:
- a fila de impressão de uma impressora compartilhada, que imprime os documentos na ordem em que foram enviados;
- o buffer do teclado, que entrega ao programa as teclas na ordem em que foram digitadas;
- as filas de processos prontos para executar, de pacotes de rede e de mensagens entre programas;
- a busca em largura, que explora primeiro os vizinhos mais próximos (é o último exercício desta página).
Operações
- enfileirar (enqueue): insere um elemento no fim;
- desenfileirar (dequeue): remove o elemento do início e o devolve;
- frente (front): consulta o elemento do início, sem removê-lo.
Como na pilha, também é comum verificar se a fila está vazia e, quando ela tem tamanho máximo, se está cheia.
Interface do TAD Fila
/* Fila.h */
#ifndef FILA_H
#define FILA_H

#include <stdbool.h>

typedef struct fila Fila;

Fila *criaFila(int capacidade);     /* capacidade: máximo de elementos */
void liberaFila(Fila *f);
void enfileira(Fila *f, int valor); /* insere no fim */
int desenfileira(Fila *f);          /* remove do início e devolve o valor */
int frenteFila(const Fila *f);      /* devolve o primeiro, sem remover */
bool filaVazia(const Fila *f);

#endif
Assim como fizemos com a pilha, vamos implementar essa interface com um vetor e com uma lista encadeada. No vetor, a implementação boa não sai de primeira: vamos passar por duas versões ingênuas, e cada uma mostra um problema que a seguinte resolve.
Implementação com vetor
Primeira tentativa: deslocar os elementos
A ideia mais direta copia a pilha: o início da fila fica sempre em
vetor[0], e um campo tamanho diz quantos elementos há. Enfileirar é
gravar na primeira posição livre; desenfileirar é tirar o vetor[0] e
deslocar todos os outros uma posição para a esquerda.
struct fila {
    int *vetor;
    int capacidade;
    int tamanho;
};

void enfileira(Fila *f, int valor) {
    if (f->tamanho == f->capacidade) {
        printf("Erro: fila cheia\n");
        return;
    }
    f->vetor[f->tamanho] = valor;
    f->tamanho++;
}

int desenfileira(Fila *f) {
    if (filaVazia(f)) {
        printf("Erro: fila vazia\n");
        return -1;
    }
    int valor = f->vetor[0];
    for (int i = 0; i < f->tamanho - 1; i++)    /* desloca todos */
        f->vetor[i] = f->vetor[i + 1];
    f->tamanho--;
    return valor;
}Qual a complexidade de enfileira e de desenfileira nessa versão?
Ver respostaEsconder resposta
enfileira é desenfileira
é vetor[0], todos os elementos restantes andam uma posição. Em uma fila
muito usada, deslocar tudo a cada remoção sai caro.
Segunda tentativa: guardar onde a fila começa
Em vez de mover os elementos, podemos mover o início: um índice inicio
guarda a posição do primeiro elemento, e um índice fim guarda a próxima
posição livre. Desenfileirar passa a ser só avançar inicio, em
struct fila {
    int *vetor;
    int capacidade;
    int inicio;     /* índice do primeiro elemento */
    int fim;        /* índice da próxima posição livre */
};

void enfileira(Fila *f, int valor) {
    if (f->fim == f->capacidade) {
        printf("Erro: fila cheia\n");
        return;
    }
    f->vetor[f->fim] = valor;
    f->fim++;
}

int desenfileira(Fila *f) {
    if (filaVazia(f)) {            /* vazia quando inicio == fim */
        printf("Erro: fila vazia\n");
        return -1;
    }
    int valor = f->vetor[f->inicio];
    f->inicio++;
    return valor;
}
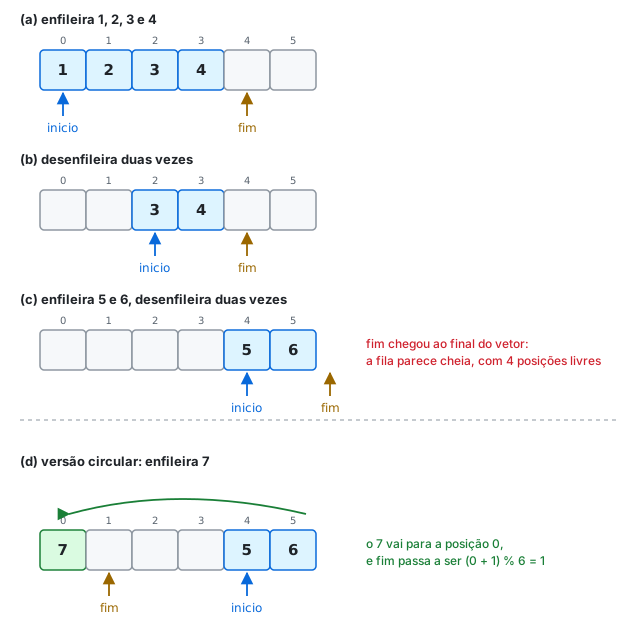
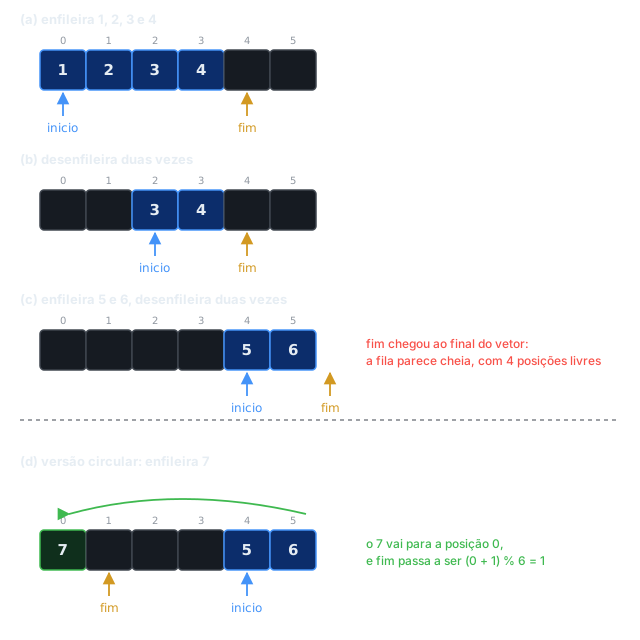
O problema aparece com o uso. Como inicio e fim só avançam, a parte
ocupada caminha para o final do vetor, e as posições liberadas no começo
nunca são reaproveitadas. As linhas (a) a (c) da figura abaixo mostram isso:
depois de algumas operações, fim chega ao final e a fila se diz cheia com
quatro das seis posições livres.
No programa abaixo, a fila nunca tem mais de um elemento (entra um, sai um), e mesmo assim, com capacidade 4, a quinta inserção falha.
A fila circular
A saída é tratar o vetor como se fosse circular: depois da última posição, vem de novo a posição 0. Quando um índice chega ao final do vetor, ele "dá a volta" e continua do começo, ocupando as posições que foram liberadas. Em C, isso se faz com o resto da divisão:
indice = (indice + 1) % capacidade;Com capacidade 8, por exemplo, o índice segue 5, 6, 7, 0, 1, ... A figura mostra uma fila com cinco elementos em que três estão no fim do vetor e dois no começo.
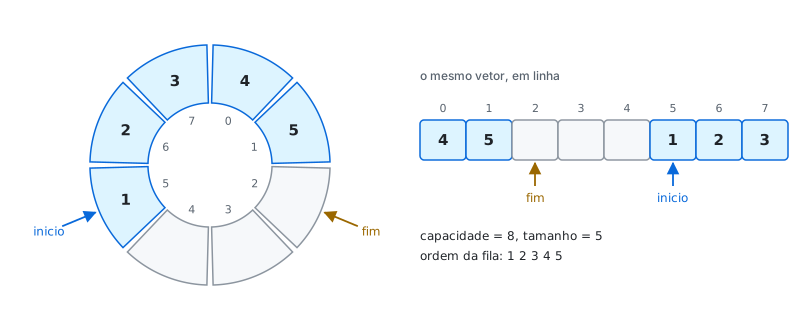
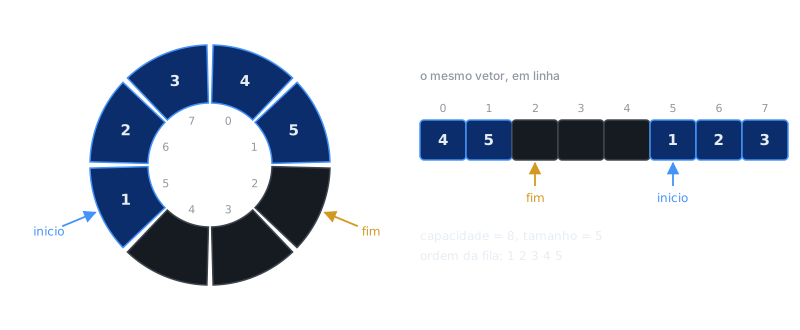
Agora inicio == fim acontece tanto na fila vazia quanto na fila cheia (com
fim tendo dado a volta até alcançar inicio). Para distinguir as duas
situações, guardamos também o tamanho:
struct fila {
    int *vetor;
    int capacidade;
    int inicio;     /* índice do primeiro elemento */
    int fim;        /* índice da próxima posição livre */
    int tamanho;    /* quantidade de elementos */
};

bool filaVazia(const Fila *f) {
    return f->tamanho == 0;
}

void enfileira(Fila *f, int valor) {
    if (f->tamanho == f->capacidade) {
        printf("Erro: fila cheia\n");
        return;
    }
    f->vetor[f->fim] = valor;
    f->fim = (f->fim + 1) % f->capacidade;
    f->tamanho++;
}

int desenfileira(Fila *f) {
    if (filaVazia(f)) {
        printf("Erro: fila vazia\n");
        return -1;
    }
    int valor = f->vetor[f->inicio];
    f->inicio = (f->inicio + 1) % f->capacidade;
    f->tamanho--;
    return valor;
}
O main.c abaixo usa uma fila de capacidade 4: enfileira três valores,
desenfileira dois e enfileira mais quatro. As duas posições liberadas no
começo do vetor são reaproveitadas, e só a última inserção é recusada,
porque aí a fila tem de fato 4 elementos.
Qual a complexidade de enfileira e desenfileira na versão circular? E
que limitação ela ainda tem?
Ver respostaEsconder resposta
As duas são
Precisamos do campo fim?
Os três campos inicio, fim e tamanho não são independentes: o fim
está sempre tamanho posições depois do inicio, dando a volta se
necessário.
fim == (inicio + tamanho) % capacidadeEntão o campo fim pode ser dispensado, e enfileira calcula a posição na
hora:
void enfileira(Fila *f, int valor) {
    if (f->tamanho == f->capacidade) {
        printf("Erro: fila cheia\n");
        return;
    }
    f->vetor[(f->inicio + f->tamanho) % f->capacidade] = valor;
    f->tamanho++;
}
Essa versão também está correta, e as duas são escolhas razoáveis. A economia de memória não pesa na decisão: são 4 bytes por fila, não por elemento. O que se troca é outra coisa:
- com o
fim, cada operação mexe no seu próprio índice (enfileiranofim,desenfileiranoinicio), e o código fica simétrico e fácil de ler. O preço é um campo redundante: toda função que altera a fila precisa manter a igualdade acima verdadeira, e um esquecimento deixa astructinconsistente; - sem o
fim, não há como os campos discordarem, porque a informação existe em um lugar só. O preço é uma conta a mais emenfileira.
Neste material ficamos com os três campos, pela simetria. Existe ainda uma
terceira opção, que dispensa o tamanho e guarda só inicio e fim. Essa,
sim, é mais complicada: inicio == fim volta a ser ambíguo (vazia ou
cheia?), e a solução usual é nunca ocupar a última posição livre, isto é,
considerar a fila cheia quando (fim + 1) % capacidade == inicio. Uma fila
de capacidade 8 passa a guardar no máximo 7 elementos.
| Campos | Vazia quando | Cheia quando | Custo |
|---|---|---|---|
inicio, fim, tamanho | tamanho == 0 | tamanho == capacidade | um campo redundante |
inicio, tamanho | tamanho == 0 | tamanho == capacidade | calcular o fim em enfileira |
inicio, fim | inicio == fim | (fim + 1) % capacidade == inicio | uma posição do vetor sempre vazia |
Implementação com lista encadeada
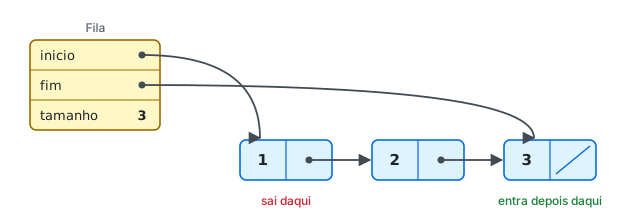
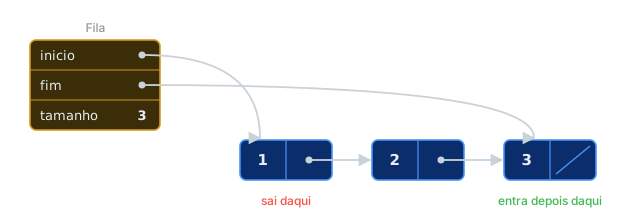
Na pilha com lista, um ponteiro para o início bastou, porque inserir e
remover acontecem na mesma ponta. Na fila, com uma lista simplesmente
encadeada, um ponteiro só (inicio) é suficiente para que todas as
operações sejam
Ver respostaEsconder resposta
Não. A fila insere e remove em pontas diferentes. Remover do início é
inicio, exige percorrer a lista até
o último nó, em fim, como na
lista com início e fim.
E se a fila inserisse no início e removesse do fim, em vez de inserir no fim e remover do início?
Ver respostaEsconder resposta
Remover do fim de uma lista simplesmente encadeada é fim: depois da remoção, o novo último é o penúltimo, e o
penúltimo só se acha percorrendo a lista. Por isso a fila insere no fim
(fim) e remove do início (
typedef struct no {
    int dado;
    struct no *proximo;
} No;

struct fila {
    No *inicio;     /* de onde se remove */
    No *fim;        /* onde se insere */
    int tamanho;
};
enfileira é a inserção no fim da lista, e desenfileira é a remoção do
primeiro nó:
void enfileira(Fila *f, int valor) {
    No *novo = malloc(sizeof(No));
    novo->dado = valor;
    novo->proximo = NULL;
    if (f->fim == NULL)             /* fila vazia */
        f->inicio = novo;
    else
        f->fim->proximo = novo;
    f->fim = novo;
    f->tamanho++;
}

int desenfileira(Fila *f) {
    if (filaVazia(f)) {
        printf("Erro: fila vazia\n");
        return -1;
    }
    No *removido = f->inicio;
    int valor = removido->dado;
    f->inicio = removido->proximo;
    if (f->inicio == NULL)          /* a fila ficou vazia */
        f->fim = NULL;
    free(removido);
    f->tamanho--;
    return valor;
}Por que desenfileira precisa verificar se inicio ficou NULL e, nesse
caso, atualizar também o fim?
Ver respostaEsconder resposta
Se a fila tinha um único elemento, esse nó era ao mesmo tempo o início e
o fim. Depois de removê-lo, inicio vira NULL, mas fim continuaria
apontando para o nó que acabou de ser liberado. O próximo enfileira
veria fim != NULL e escreveria em fim->proximo, dentro de memória
liberada. É o mesmo cuidado da remoção do último nó em uma lista com
início e fim. O Programa
2 dos exercícios mostra o que acontece sem essa linha.
O programa abaixo usa o mesmo main.c e o mesmo Fila.h da versão
circular. Compare as saídas: a única diferença é que o 70 agora entra,
porque a fila com lista não tem limite de capacidade.
Vetor ou lista encadeada?
| Vetor circular | Lista encadeada | |
|---|---|---|
| Operações | todas | todas |
| Capacidade | fixa, definida na criação | cresce e diminui livremente |
| Memória | o vetor inteiro, mesmo com a fila quase vazia | um nó (dado + ponteiro) por elemento |
| Alocações | uma só, na criação | um malloc por enfileira e um free por desenfileira |
Uma fila circular tem capacidade = 5, inicio = 3 e tamanho = 4. Em
que posição do vetor o próximo enfileira grava o novo valor?
Exemplo: o problema de Josefo, com uma fila
Em listas circulares, o problema de Josefo
foi resolvido com uma lista circular:
Se ainda não resolveu o problema de Josefo com a lista circular, tente antes de ler esta seção.
Uma fila também serve, e de um jeito curioso: "andar" no círculo é tirar a
pessoa do início da fila e colocá-la de volta no fim. Depois de Fila.c com vetor) sem nenhuma alteração.
A fila faz o papel da lista circular: o início da fila é a pessoa da vez, e
quem é "pulado" volta para o fim. Cada eliminação custa
Por que uma fila com capacidade
Ver respostaEsconder resposta
Cada rotação desenfileira antes de enfileirar, então a fila nunca passa
de fim "acabe".
Com
Ver respostaEsconder resposta
Dar tamanho rotações seguidas devolve a fila ao mesmo estado. Basta
então fazer (k - 1) % tamanho rotações, em que tamanho é o número de
pessoas ainda na fila. É o mesmo truque do exercício com a lista
circular.
Em muitas filas reais, como a de um pronto-socorro, a ordem de atendimento depende da urgência, e não só da ordem de chegada. Essa estrutura se chama fila de prioridade, e vamos estudá-la mais adiante, com uma implementação eficiente baseada em heap.
Exercícios
Encontre e corrija o erro
Programa 1
Resposta
desenfileira dá a volta com % capacidade, mas enfileira não: faz só
f->fim++. Depois de quatro inserções, fim vale 4; as duas remoções
liberam as posições 0 e 1, e o enfileira(f, 5) grava em vetor[4], uma
posição depois do fim do vetor (heap-buffer-overflow). O correto é:
f->fim = (f->fim + 1) % f->capacidade;Programa 2
Resposta
Quando a fila fica vazia, desenfileira deixa fim apontando para o nó que
acabou de liberar. O enfileira(f, 2) seguinte vê fim != NULL, conclui que
a fila não está vazia e escreve em f->fim->proximo, dentro do nó liberado
(heap-use-after-free). Falta, depois de avançar o inicio:
if (f->inicio == NULL)
    f->fim = NULL;
Programa 3
Deveria atender os três pedidos, na ordem de chegada.
Resposta
filaVazia testa inicio == fim, mas, na fila circular, isso também
acontece quando a fila está cheia: com capacidade 3, depois de três
inserções, fim dá a volta e vale 0, igual a inicio. O laço do main
acha que a fila está vazia e não atende ninguém. Como a struct guarda o
tamanho, o teste correto é
return f->tamanho == 0;É a ambiguidade da terceira representação, sem a posição sacrificada que a resolveria.
Implemente
Fila com duas pilhas. Implemente a interface Fila.h usando duas
pilhas (a de Pilha.c, com lista encadeada) e nada mais: a pilha de
entrada recebe os elementos enfileirados, e a de saida entrega os
desenfileirados. Os testes fazem centenas de milhares de operações, e cada
uma deve ter custo amortizado
Ao desempilhar todos os elementos de uma pilha e empilhá-los em outra, em que ordem eles ficam?
Ver dica 1Esconder dica 1
A ordem se inverte: o elemento que estava no fundo da entrada (o
primeiro que chegou) fica no topo da saida.
Ver dica 2Esconder dica 2
Não transfira a cada operação. Se a saida ainda tem elementos, o
próximo a sair já está no topo dela. Quantas vezes, no máximo, cada
elemento passa de uma pilha para a outra?
Menor caminho no labirinto. Na página de backtracking,
o labirinto foi resolvido experimentando caminhos e desfazendo escolhas, o
que leva tempo exponencial no pior caso. Para achar o menor caminho de
S até E, existe um algoritmo muito mais eficiente, a busca em largura
(breadth-first search, BFS), e ele é feito com uma fila:
- a célula
Sestá a distância 0; enfileire-a; - enquanto a fila não estiver vazia, desenfileire uma célula e, para cada vizinha livre que ainda não foi alcançada, anote a distância (a da célula atual mais 1) e enfileire-a;
- a distância anotada em
Eé a resposta.
Como a fila é FIFO, todas as células a distância 1 saem antes das células a distância 2, que saem antes das a distância 3, e assim por diante: a busca avança em "ondas", e a primeira vez que uma célula é alcançada é sempre pelo caminho mais curto. Cada célula entra na fila no máximo uma vez, então o custo é proporcional ao tamanho do mapa. Os testes usam mapas de 800 por 800, nos quais testar todos os caminhos com backtracking não terminaria.
Referências
- W. Celes, R. Cerqueira e J. L. Rangel. Introdução a Estruturas de Dados: com técnicas de programação em C. 2ª ed. Grupo GEN, 2016.
- A. Backes. Estrutura de Dados Descomplicada em Linguagem C. Elsevier, 2016.
- Josephus problem. Wikipedia.
Pilhas
Estrutura LIFO, em que só o topo é acessível. Interface do TAD, implementações com vetor e com lista encadeada, e o casamento de delimitadores.
Tabela de símbolos
O TAD que associa valores a chaves únicas. Interface, implementações com lista encadeada e com vetor ordenado (busca binária) e a comparação de custos que motiva as árvores.